Acte I · Le problème
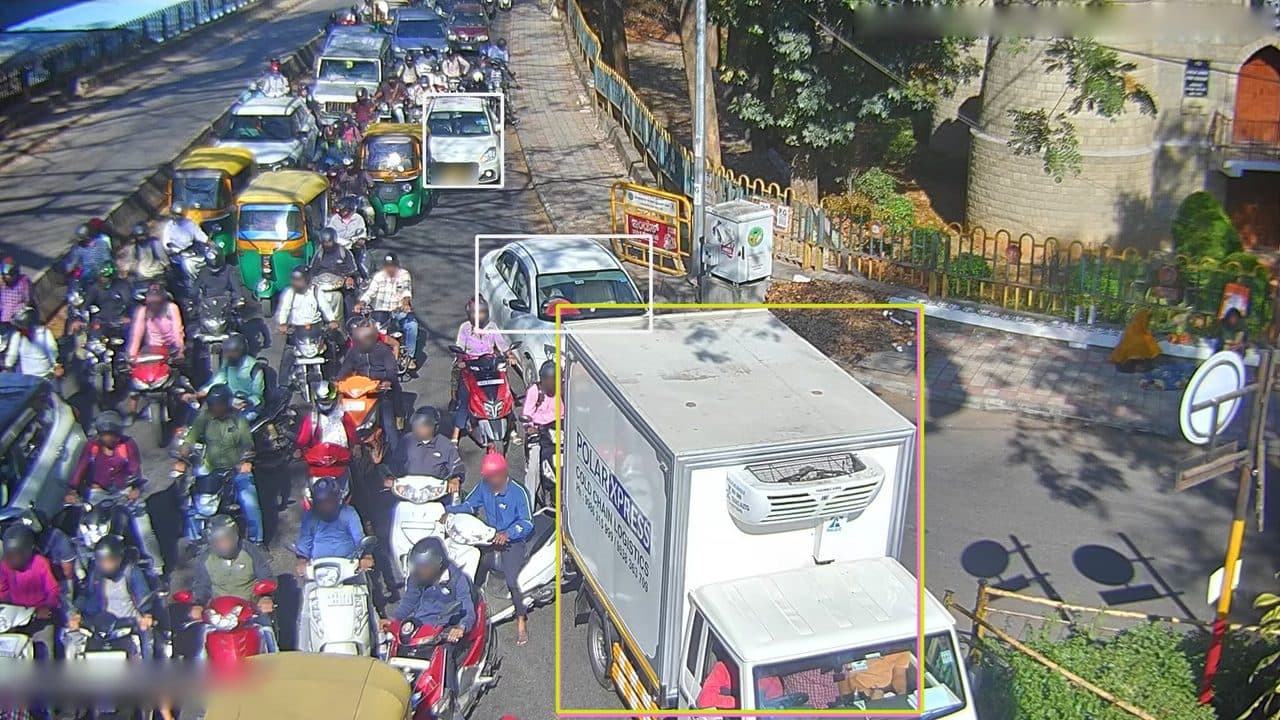
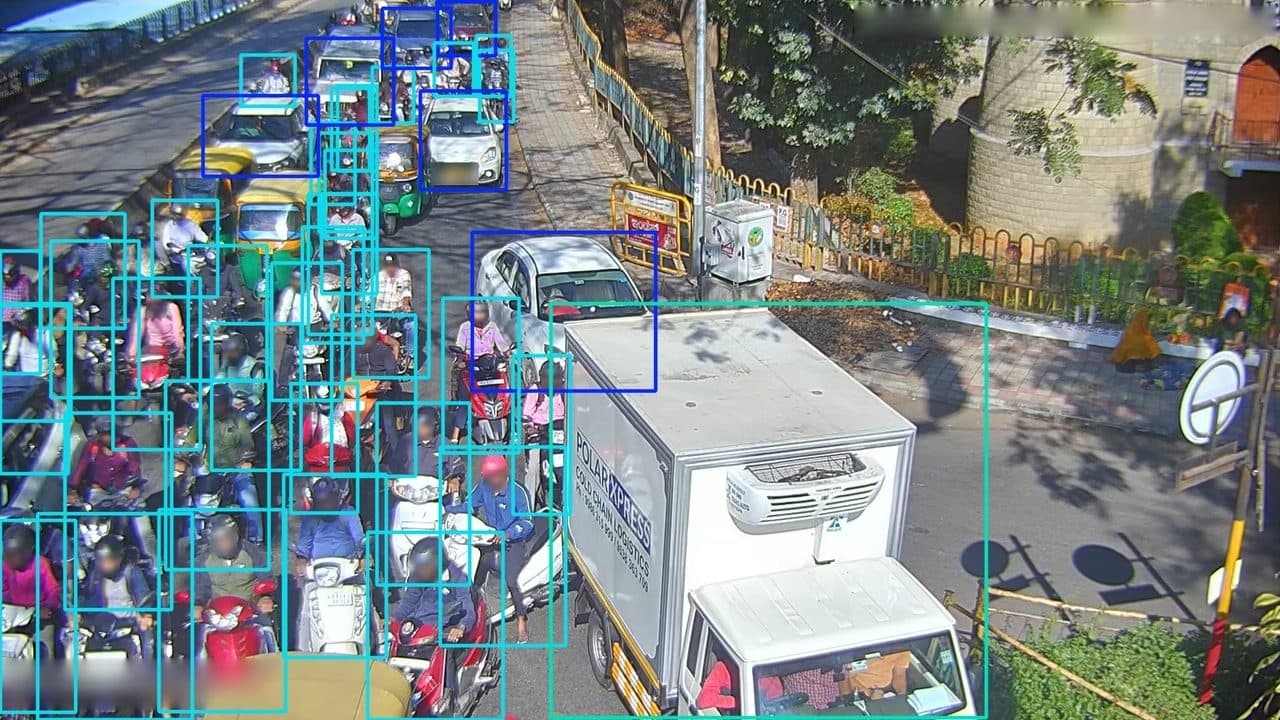
YOLOv8 pré-entraîné sur COCO reconnaît très bien une voiture qui remplit l’image. Mais dans une scène d’embouteillage filmée en hauteur, les véhicules éloignés deviennent minuscules et se chevauchent, et c’est exactement là que le modèle généraliste décroche.
La question du projet est précise : qu’est-ce qu’un fine-tuning sur des données de trafic dense change réellement, mesuré proprement, en particulier sur les petits objets ?
Acte II · La démarche
Premier constat, assumé dès le départ : il n’existe aucun jeu de données public de vision par ordinateur spécifique au Bénin. Plutôt que de prétendre le contraire, le projet utilise le jeu public le plus proche du problème : BMD-45, filmé par des caméras de surveillance à Bengaluru, en Inde. Le contexte béninois est la motivation du projet, pas la provenance de ses données, et cette transparence fait partie du protocole.
- Environ 3 000 images extraites de BMD-45 (45 000 au total), découpage train / test isolé.
- 4 classes compatibles COCO : voiture, moto, bus, camion.
- YOLOv8n évalué tel quel, puis fine-tuné sur ces données.
- Comparaison sur le même jeu de test, rappel ventilé par taille d’objet : petit, moyen, grand.
règle du jeu : tout est fixé avant le premier entraînement, ce qu’on fixe avant protège de ce qu’on aimerait se raconter après
Acte III · Les résultats
| Métrique | Avant | Après | Évolution |
|---|---|---|---|
| mAP@0.5 | 0.438 | 0.825 | +88.4 % |
| mAP@0.5:0.95 | 0.296 | 0.644 | +117.8 % |
| Précision | 0.496 | 0.833 | +67.9 % |
| Rappel | 0.417 | 0.714 | +71.1 % |
| F1-score | 0.453 | 0.769 | +69.6 % |
| Débit (FPS) | 37.2 | 43.2 | +16.2 % |
- Petits (804)0.12 → 0.69 · +469,3 %
- Moyens (1 415)0.37 → 0.88 · +135,6 %
- Grands (332)0.79 → 0.95 · +20,1 %
Ces chiffres valent sur le jeu de test de BMD-45, pas sur les routes béninoises, faute de données locales publiques. Et l’inférence sur processeur classique prend 1 à 2 secondes par image : suffisant pour une démonstration, pas pour du temps réel sans matériel dédié.
Acte IV · Ce que j’ai appris
Les moyennes mentent par omission
Le mAP global du modèle de départ ne disait pas l’essentiel : presque neuf petits véhicules ratés sur dix. C’est la ventilation par taille qui a posé le vrai problème sur la table. Depuis, je ne crois plus une métrique avant de l’avoir découpée.
Le protocole se joue avant
Comme une ouverture aux échecs : jeu de test isolé, métriques et règles de comparaison décidées avant le premier entraînement. Ce qu’on fixe avant protège de ce qu’on aimerait se raconter après.
La transparence est un choix méthodologique
Écrire noir sur blanc qu’aucun jeu de données béninois n’existe a rendu le projet plus solide, pas plus fragile : on sait exactement ce que nos chiffres prouvent, et ce qu’ils ne prouvent pas.
Un rappel de 0.12 n’est pas une honte
C’est le début du récit. Les personnages de mes histoires préférées grandissent à force de tomber ; un modèle progresse pareil, et celle qui l’entraîne aussi.
documenter, c’est penser : chaque page rédigée a clarifié une décision pendant qu’il était encore temps d’en changer